~/blog/infraestructura-stateless-escalar-aplicaciones.md
Infraestructura stateless: la base para escalar aplicaciones sin dolor
Por qué diseñar aplicaciones sin estado en el servidor es clave para escalar horizontalmente, desplegar sin cortes y recuperarse de fallas, y cómo hacerlo bien sin caer en errores comunes.
- autor
- Alejandro Peñaloza
- Publicado
- Lectura
- 7 min
- English
- Read in English →
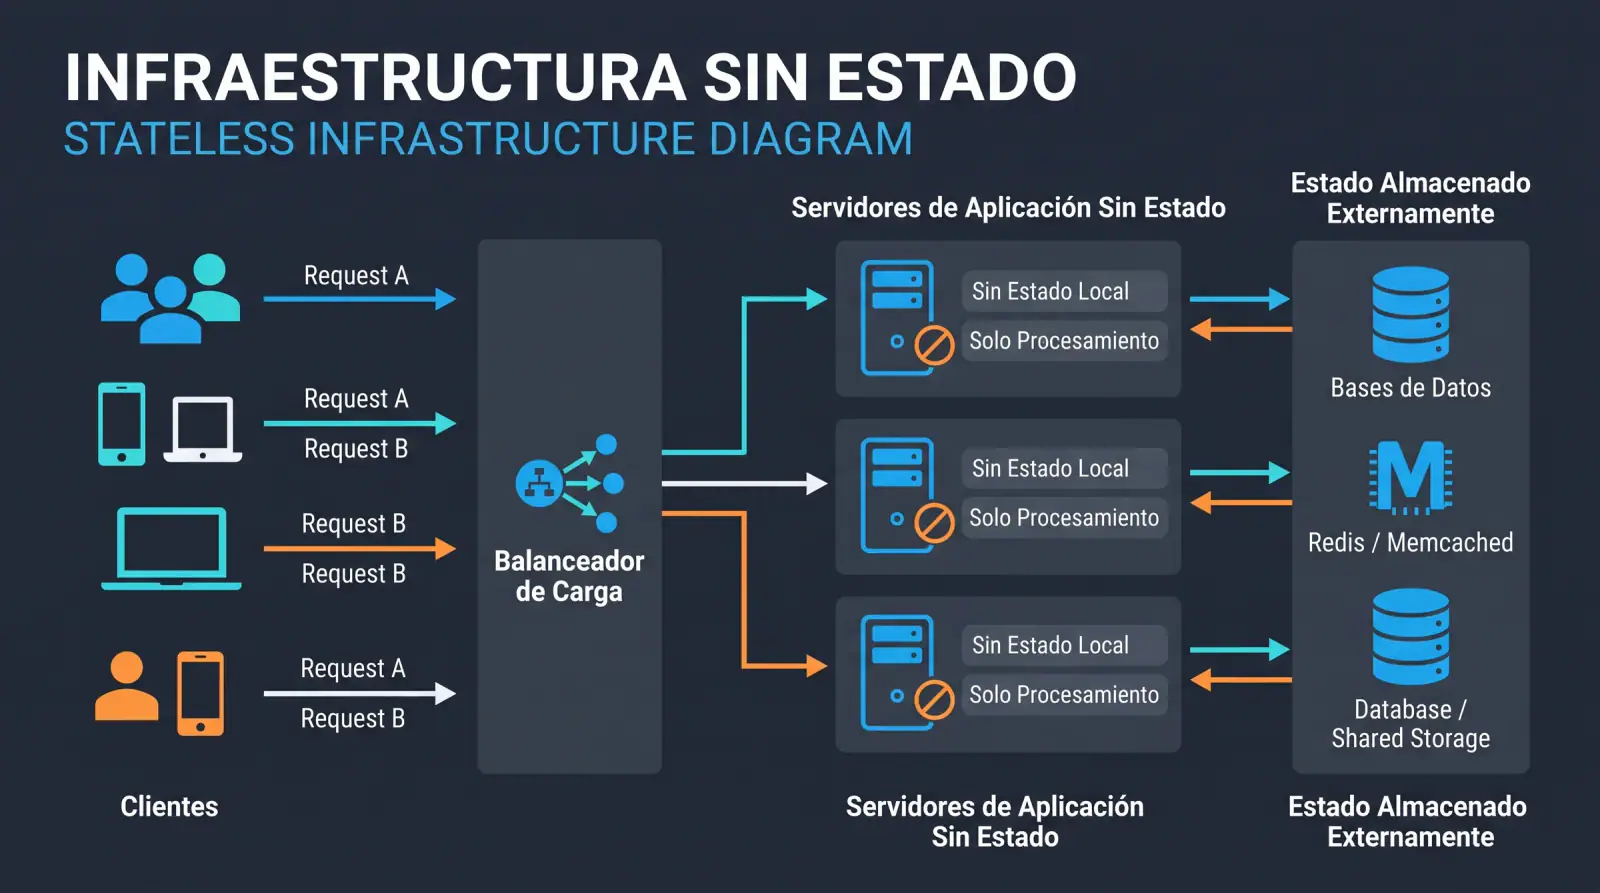
En este artículo
Tarde o temprano toda aplicación que crece se topa con el mismo muro: un solo servidor ya no alcanza. Se agrega una segunda instancia detrás de un balanceador y, de pronto, los usuarios pierden la sesión, los archivos subidos "desaparecen" y los trabajos programados se ejecutan dos veces.
El problema casi nunca es la cantidad de servidores. Es el estado que cada servidor guarda por su cuenta. En este artículo explico qué significa una infraestructura stateless (sin estado), por qué es la base del escalamiento moderno y cómo llevarla a la práctica sin caer en los errores típicos.
¿Qué significa "stateless"?
Una aplicación es stateless cuando cualquier instancia puede atender cualquier petición, porque ninguna guarda información local que sea necesaria para la siguiente petición.
Eso no significa que la aplicación no tenga estado. Significa que el estado vive fuera del proceso: en una base de datos, en una caché distribuida, en un almacenamiento de objetos o en el propio cliente (por ejemplo, un token firmado).
| Tipo de estado | Stateful (en la instancia) | Stateless (externalizado) |
|---|---|---|
| Sesiones de usuario | Memoria o disco local | Redis, base de datos o JWT |
| Archivos subidos | Carpeta local del servidor | Almacenamiento de objetos (S3 o compatible) |
| Caché | Memoria del proceso | Caché distribuida (Redis, Memcached) |
| Tareas en segundo plano | Cron en cada servidor | Cola de mensajes + workers |
| Configuración | Archivos editados a mano | Variables de entorno y gestor de secretos |
| Logs | Archivos en disco | Salida estándar enviada a un agregador |
El problema: escalar una aplicación con estado
Imagina una aplicación que guarda la sesión del usuario en la memoria del servidor. Con una sola instancia funciona perfecto. Con dos, el balanceador reparte las peticiones y el usuario rebota entre servidores que no se conocen entre sí.
sequenceDiagram
    participant U as Usuario
    participant LB as Balanceador
    participant A as Instancia A
    participant B as Instancia B
    U->>LB: POST /login
    LB->>A: Reenvía petición
    A-->>U: OK, sesión guardada en memoria de A
    U->>LB: GET /mi-cuenta
    LB->>B: Reenvía petición
    B-->>U: 401 No autenticado
    Note over B: B no conoce la sesión creada en A
La solución "rápida" suele ser activar sticky sessions, es decir, que el balanceador mande siempre al mismo usuario a la misma instancia. Funciona, pero es un parche:
- La carga se reparte de forma desigual.
- Si la instancia cae, todos sus usuarios pierden la sesión.
- Escalar hacia abajo (apagar instancias) corta sesiones activas.
- Los despliegues se vuelven delicados porque cada instancia "importa".
La arquitectura stateless
En un diseño stateless, las instancias de la aplicación son intercambiables y desechables. Todo lo que debe persistir sale hacia servicios especializados.
flowchart TB
    U["Usuarios"] --> LB["Balanceador de carga"]
    LB --> A1["App instancia 1"]
    LB --> A2["App instancia 2"]
    LB --> A3["App instancia N"]

    subgraph Estado["Capa de estado compartido"]
        DB[("Base de datos")]
        R[("Caché / sesiones")]
        S3[("Almacenamiento de objetos")]
        Q[["Cola de mensajes"]]
    end

    A1 --> DB
    A2 --> DB
    A3 --> DB
    A1 --> R
    A2 --> R
    A3 --> R
    A1 --> S3
    A2 --> S3
    A3 --> S3
    A1 --> Q
    A2 --> Q
    A3 --> Q
    Q --> W["Workers en segundo plano"]
    W --> DB
La idea clave: la capa de aplicación escala horizontalmente sin coordinación, mientras la capa de estado se escala con herramientas pensadas para eso (réplicas de lectura, clústeres de caché, almacenamiento gestionado).
Por qué importa: los beneficios reales
1. Escalamiento horizontal inmediato
Si cualquier instancia puede atender cualquier petición, agregar capacidad es tan simple como levantar más réplicas. Esto habilita el autoescalado: el orquestador crea o destruye instancias según CPU, memoria, latencia o largo de la cola.
flowchart LR
    M["Métricas: CPU, latencia, peticiones/s"] --> AS{"¿Supera el umbral?"}
    AS -- Sí --> UP["Agregar réplicas"]
    AS -- No, carga baja --> DOWN["Quitar réplicas"]
    AS -- Dentro del rango --> KEEP["Mantener"]
    UP --> M
    DOWN --> M
    KEEP --> M
2. Resiliencia ante fallas
Cuando una instancia muere, no se pierde nada importante. El balanceador deja de enviarle tráfico y el orquestador la reemplaza. El usuario, en el peor caso, reintenta una petición.
3. Despliegues sin cortes
Con instancias desechables es posible hacer rolling updates o despliegues blue/green: se levantan instancias con la versión nueva, se verifica que estén sanas y se retiran las antiguas, sin ventana de mantención.
flowchart LR
    subgraph Antes
        V1a["v1"]
        V1b["v1"]
        V1c["v1"]
    end
    subgraph Durante
        V2a["v2"]
        V1d["v1"]
        V1e["v1"]
    end
    subgraph Despues["Después"]
        V2b["v2"]
        V2c["v2"]
        V2d["v2"]
    end
    Antes --> Durante --> Despues
4. Costos más eficientes
Pagar por capacidad fija dimensionada para el peak es caro. Con instancias stateless se puede escalar hacia abajo en horas valle sin miedo a cortar sesiones, y aprovechar instancias más baratas (como spot o preemptible) porque perder una no es un drama.
5. Entornos reproducibles
Si la instancia no tiene nada especial, se puede describir completa como código: una imagen de contenedor más variables de entorno. Eso hace que desarrollo, pruebas y producción se parezcan mucho más.
Cómo llevarlo a la práctica
Sesiones fuera del proceso
Hay dos caminos principales:
- Sesión en un almacén compartido (Redis o base de datos): el servidor guarda solo un identificador en una cookie. Permite invalidar sesiones al instante.
- Tokens firmados (por ejemplo, JWT): el estado viaja en el token. No requiere almacén, pero revocar es más difícil, así que conviene usar expiraciones cortas y refresh tokens.
En muchos frameworks el cambio es de configuración. Por ejemplo, en Laravel:
SESSION_DRIVER=redis
CACHE_STORE=redis
QUEUE_CONNECTION=redis
FILESYSTEM_DISK=s3
Archivos en almacenamiento de objetos
Nada de guardar subidas en /var/www/uploads. Los archivos van a un almacenamiento de objetos y la aplicación solo guarda la referencia. Para archivos grandes conviene usar URLs prefirmadas, de modo que el cliente suba directo al almacenamiento sin pasar por la aplicación.
sequenceDiagram
    participant C as Cliente
    participant API as API stateless
    participant S as Almacenamiento de objetos
    C->>API: Solicita subir archivo
    API-->>C: URL prefirmada con expiración
    C->>S: PUT archivo directo
    S-->>C: 200 OK
    C->>API: Confirma subida con la clave del objeto
    API->>API: Guarda la referencia en la base de datos
Tareas en segundo plano con colas
Un cron configurado en cada servidor se ejecuta N veces si hay N instancias. La alternativa:
- Las peticiones encolan trabajos en una cola de mensajes.
- Un grupo separado de workers los consume, y también escala de forma independiente.
- Las tareas programadas se disparan desde un único planificador o usando un lock distribuido para garantizar una sola ejecución.
Configuración y secretos
Siguiendo el principio de The Twelve-Factor App, la configuración entra por variables de entorno y los secretos desde un gestor dedicado. La misma imagen de contenedor debe poder correr en cualquier ambiente cambiando solo su configuración.
Logs como flujo de eventos
La aplicación escribe a la salida estándar y la plataforma se encarga de recolectar y centralizar. Si los logs viven en el disco de una instancia efímera, se pierden con ella.
Health checks
Cada instancia debe exponer endpoints que el orquestador y el balanceador puedan consultar:
// Liveness: ¿el proceso está vivo?
app.get('/healthz', (_req, res) => res.status(200).send('ok'));

// Readiness: ¿puede atender tráfico? (depende de sus servicios externos)
app.get('/readyz', async (_req, res) => {
  const dbOk = await db.ping().catch(() => false);
  const cacheOk = await redis.ping().then(() => true).catch(() => false);
  res.status(dbOk && cacheOk ? 200 : 503).json({ db: dbOk, cache: cacheOk });
});
Apagado ordenado
Cuando el orquestador retira una instancia, envía una señal (SIGTERM). La aplicación debe dejar de aceptar peticiones nuevas, terminar las que están en curso y cerrar conexiones antes de salir.
process.on('SIGTERM', async () => {
  server.close();          // no aceptar nuevas conexiones
  await queue.pause();     // dejar de tomar trabajos
  await db.disconnect();   // cerrar recursos limpiamente
  process.exit(0);
});
Buen uso: errores comunes que conviene evitar
Pasar a stateless no es solo mover sesiones a Redis. Estos son los tropiezos más frecuentes:
- Mover el cuello de botella a la base de datos. Si escalas la app a 20 réplicas, cada una abre su pool de conexiones. Usa un connection pooler (como PgBouncer para PostgreSQL), réplicas de lectura y caché para no saturar la base.
- Caché local escondida. Variables estáticas, singletons con datos o cachés en memoria generan inconsistencias entre instancias. Si debe compartirse, va a la caché distribuida.
- Escrituras en disco "temporales" que no lo son. Archivos generados que luego se descargan en otra petición fallarán cuando esa petición caiga en otra instancia.
- No diseñar para la idempotencia. En sistemas distribuidos los reintentos son normales. Los endpoints críticos y los workers deben tolerar recibir el mismo mensaje dos veces (por ejemplo, usando claves de idempotencia).
- WebSockets sin plan. Las conexiones persistentes son estado por naturaleza. Usa un adaptador con pub/sub (Redis, NATS) para que un mensaje llegue al cliente sin importar en qué instancia esté conectado.
- Olvidar que la capa de estado también debe ser resiliente. Externalizar el estado traslada la responsabilidad: la base de datos, la caché y el almacenamiento necesitan respaldos, réplicas y monitoreo.
- Migraciones que rompen versiones anteriores. Durante un rolling update conviven la versión vieja y la nueva. Los cambios de esquema deben ser compatibles hacia atrás (patrón expand and contract).
flowchart LR
    E["1. Expandir: agregar columna nueva, opcional"] --> D["2. Desplegar código que escribe en ambas"]
    D --> M["3. Migrar datos existentes"]
    M --> L["4. Desplegar código que lee solo la nueva"]
    L --> C["5. Contraer: eliminar columna antigua"]
¿Cuándo no vale la pena?
Ser honesto con el contexto también es buen uso:
- Una herramienta interna con pocos usuarios y sin requisitos de disponibilidad puede vivir tranquila en un solo servidor.
- Algunos sistemas son inherentemente stateful (bases de datos, motores de juego en tiempo real, sistemas de streaming) y requieren otras estrategias, como particionamiento o réplicas con consenso.
Aun así, diseñar pensando en stateless desde el inicio cuesta poco y evita una migración dolorosa cuando la aplicación crezca.
Checklist rápido
- Las sesiones no dependen de la memoria ni del disco de la instancia.
- Los archivos subidos van a almacenamiento de objetos.
- La caché compartida es distribuida.
- Las tareas pesadas pasan por una cola y workers separados.
- Las tareas programadas se ejecutan una sola vez, aunque haya N instancias.
- La configuración y los secretos llegan por entorno o gestor de secretos.
- Los logs salen por la salida estándar hacia un agregador.
- Existen health checks de liveness y readiness.
- La aplicación maneja
SIGTERMy se apaga de forma ordenada. - Las migraciones son compatibles con la versión anterior.
- Puedo destruir cualquier instancia en cualquier momento sin que nadie lo note.
Ese último punto es la mejor prueba: si matar una instancia al azar te da miedo, todavía tienes estado escondido.
Conclusión
La infraestructura stateless no es una moda ni algo exclusivo de grandes empresas. Es la condición que hace posible escalar horizontalmente, desplegar sin cortes, sobrevivir a fallas y pagar solo por lo que se usa. El trabajo consiste en algo conceptualmente simple: sacar el estado de las instancias y ponerlo en servicios diseñados para cuidarlo.
Una vez hecho, la aplicación deja de ser un conjunto de servidores "mascota" que hay que cuidar uno por uno y pasa a ser un rebaño de instancias idénticas que se crean y destruyen según la demanda. Y ahí es donde escalar deja de doler.
Comentarios
Aún no hay comentarios. ¿Quieres dejar el primero?
Deja un comentario
$ ls ~/blog | grep relacionados
Sigue leyendo
Bitácora de guerra: depurar CORS, refactorizar código propio e integrar Webpay sin perder la tarde
Problemas reales y cómo los resolví: un error de CORS que solo fallaba en producción, una fuga de memoria en el servidor, código mío de hace un año refactorizado sin vergüenza y una guía práctica para integrar Webpay Plus, Mercado Pago y Flow.
Productividad para desarrolladores: VS Code, Git avanzado, gestión ágil y scripts de automatización
Mi flujo de trabajo diario como desarrollador: las extensiones y ajustes de VS Code que sí aportan, Git más allá de commit y push (rebase, cherry-pick y bisect), cómo gestionar proyectos pequeños sin burocracia y los scripts que automatizan lo repetitivo.
De localhost a producción sin llorar: VPS, DNS, hosting y Docker para desarrolladores
Guía práctica para sacar un proyecto a producción: cómo asegurar un VPS desde cero, configurar DNS y Cloudflare, elegir entre hosting compartido, VPS o cloud, y levantar tu base de datos local con Docker Compose en segundos.